Kontext
Moderne digitale Produkte erzeugen kontinuierlich grosse Mengen an Nutzungsdaten über Web, Mobile Apps und Backend-Systeme. In vielen Organisationen scheitert nicht die Datenerfassung, sondern die Fähigkeit, Daten konsistent, skalierbar und in hoher Qualität verfügbar zu machen. Typische Ursachen sind fragmentierte Tracking-Setups, fehlende Schema-Kontrolle, unklare Datenflüsse und Systeme, die unter Last instabil werden.
Rolle und Beitrag
Im beschriebenen Umfeld habe ich als Data Scientist und Technical Lead die Architektur der End-to-End Datenplattform massgeblich gestaltet und die Umsetzung mitverantwortet: von Ingestion bis Serving, inklusive Event-Datenmodellierung, Streaming- und Batch-Pipelines sowie technischer Koordination der Realisierung.
Externe Referenz
Weitere Einblicke in die Plattform und ihren Einsatz: https://www.databricks.com/customers/srf
Architektur - Überblick
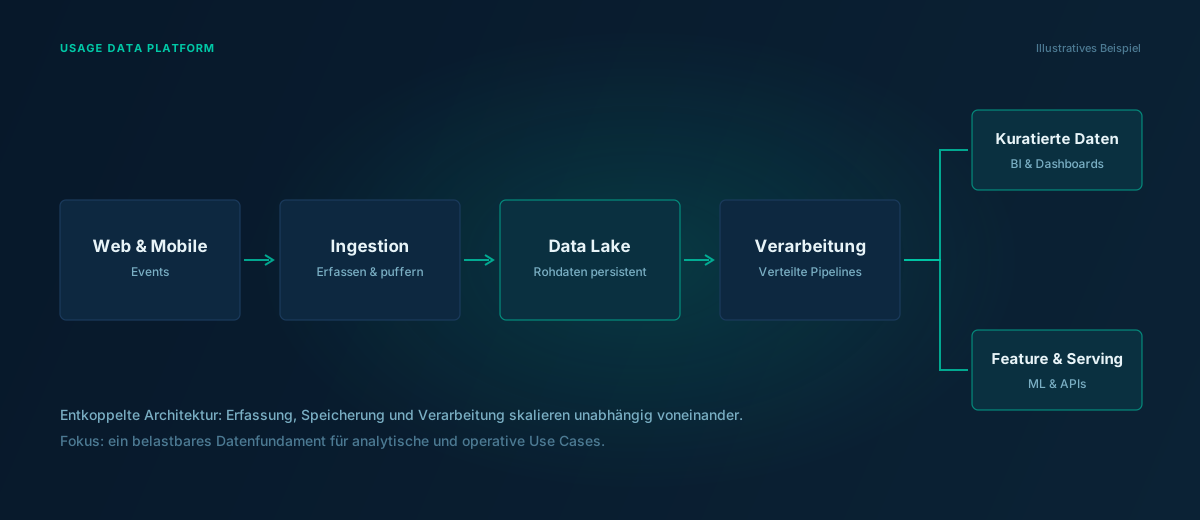
Die Plattform folgt einem event-getriebenen, entkoppelten Datenfluss: Web und Mobile Tracking führen in eine Streaming-Ingestion, dann in Raw Storage im Data Lake, danach in eine verteilte Processing Layer. Von dort aus werden einerseits kuratierte Analytics-Daten und andererseits Feature- bzw. Serving-Layer bereitgestellt - für BI, Dashboards, ML, APIs und produktive Anwendungen.
Warum Entkopplung zentral ist
Die konsequente Trennung von Datenerfassung, Speicherung, Verarbeitung und Nutzung erlaubt unabhängige Skalierung, bessere Wartbarkeit und höhere Robustheit. Komponenten können isoliert entwickelt, getestet und betrieben werden, ohne das Gesamtsystem zu destabilisieren.
Ingestion und Event-Modell
Um inkonsistente Client-Versionen, sich ändernde Event-Strukturen und fehlerhafte Payloads zu kontrollieren, wurde ein strukturiertes Event-Modell mit versionierten Schemas, klarer Trennung von Pflicht- und optionalen Feldern sowie definierten Datenverträgen eingeführt. Datenqualität wird damit bereits am Einstiegspunkt abgesichert.
Storage Layer - Data Lake als System of Record
Alle eingehenden Daten werden unverändert, append-only und zeitbasiert partitioniert im Data Lake gespeichert. Diese Struktur erlaubt vollständige Reproduzierbarkeit, gezieltes Reprocessing historischer Daten und transparente Nachvollziehbarkeit der Datenflüsse. Der Data Lake fungiert als Single Source of Truth.
Processing Layer - Mehrstufige Veredelung
Die verteilte Verarbeitung erfolgt über Raw, Clean und Business Layer. Raw speichert Originaldaten mit minimaler Transformation. Clean validiert, bereinigt und harmonisiert Strukturen. Business modelliert Domänenkonzepte wie Sessions, leitet Metriken ab und optimiert Datenmodelle für konkrete Use Cases.
Pipeline Design
Die Pipelines arbeiten inkrementell, deterministisch und reproduzierbar: Event Stream -> Raw Data -> Validation and Cleaning -> Structured Data -> Aggregation -> Business Metrics. Dadurch lassen sich Änderungen sicher ausrollen, Fehler rückwirkend korrigieren und neue Anforderungen ohne Systembruch integrieren.
Herausforderungen und Lösungen
Schema Evolution: Versionierung und rückwärtskompatible Transformationen. Datenqualität: Validierung auf mehreren Ebenen und klare Trennung von Roh- und bereinigten Daten. Skalierung: verteilte Verarbeitung, Partitionierung und elastische Ressourcen. Reprocessing: Persistenz aller Rohdaten plus deterministische Pipelines.
Ergebnis und Relevanz für viwiv
Das Resultat ist eine produktionsfähige Datenplattform, die grosse Datenmengen stabil verarbeitet, konsistente Daten liefert und flexibel auf neue Anforderungen reagiert. Der Case zeigt übertragbare Kompetenzen in Event-driven Architekturdesign, skalierbaren Data Platforms und End-to-End Data Pipelines - mit Fokus auf systemisches Design statt isolierter Technologieentscheidungen.
Hinweis
Dieser Case basiert auf öffentlich verfügbaren Informationen sowie abstrahierten Architekturprinzipien und enthält keine vertraulichen oder internen Details.