Das Missverständnis mit grossen Datensätzen
Die grossen Foundation Models benötigen enorme Datenmengen.
Das bedeutet jedoch nicht, dass jedes KI-Projekt möglichst viele Daten braucht.
Gerade im Mittelstand entstehen oft gute Resultate mit kleineren Datensätzen, klar definierten Prozessen, fokussierten Fragestellungen und sauber strukturierten Informationen.
Denn operative KI arbeitet häufig auf sehr spezifischen Problemen:
- Kundensegmentierung
- Nachfrageprognosen
- Dokumentenanalyse
- Wissenssuche
- Prozessoptimierung
- Klassifikation
- Priorisierung
Dafür sind Qualität und Relevanz meist wichtiger als reine Masse.
Mehr Daten lösen schlechte Prozesse nicht
Viele Unternehmen hoffen, dass grosse Datenmengen fehlende Struktur kompensieren.
Das passiert selten.
Wenn Daten inkonsistent, unvollständig, veraltet, doppelt oder widersprüchlich sind, werden auch grosse Datensätze problematisch.
Mehr Daten bedeuten dann oft: mehr Komplexität — nicht bessere Ergebnisse.
Kleine Datensätze können sehr wertvoll sein
Gerade KMU unterschätzen häufig den Wert ihrer vorhandenen Daten.
Dabei reichen oft bereits:
- saubere Prozessdaten
- strukturierte Kundeninformationen
- konsistente Historien
- klar definierte Kategorien
- stabile Kennzahlen
um sinnvolle Modelle zu entwickeln.
Entscheidend ist nicht, ob Millionen Datensätze existieren. Sondern: ob die vorhandenen Daten tatsächlich etwas über das Problem aussagen.
Was Datenqualität konkret bedeutet
Datenqualität ist mehr als technische Korrektheit.
Gute Daten sind:
- konsistent
- vollständig
- aktuell
- nachvollziehbar
- relevant
- repräsentativ
Das klingt selbstverständlich — ist in der Praxis aber selten sauber umgesetzt.
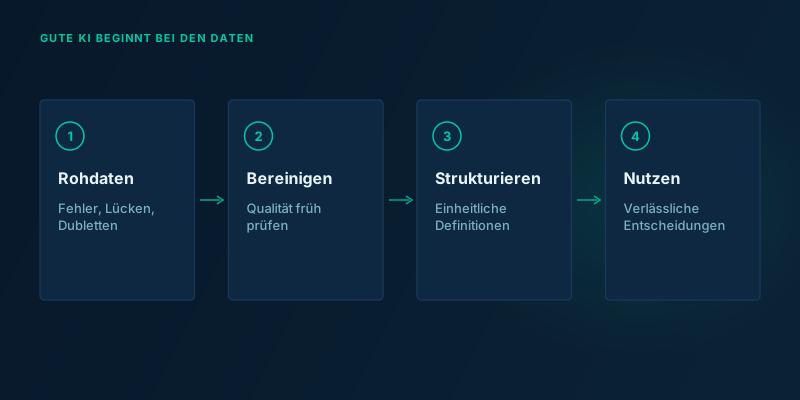
Fehlerhafte Daten erzeugen fehlerhafte Resultate
KI-Systeme lernen aus vorhandenen Daten.
Wenn diese Fehler enthalten, Verzerrungen aufweisen, falsch kategorisiert wurden oder wichtige Informationen fehlen, übernimmt das Modell genau diese Probleme.
Der Algorithmus erkennt nicht automatisch, welche Daten sinnvoll sind.
Dadurch entstehen:
- falsche Vorhersagen
- schlechte Klassifikationen
- instabile Resultate
- irreführende Muster
Kleine Datensätze sind besonders empfindlich
Bei kleinen Datenmengen wirken sich Fehler stärker aus.
Einzelne Ausreisser können:
- Trends verzerren
- Kategorien verschieben
- Vorhersagen verfälschen
- falsche Zusammenhänge erzeugen
Gerade deshalb ist Qualitätsarbeit bei kleineren Datensätzen besonders wichtig.
Datenbereinigung wird oft unterschätzt
Viele Projekte fokussieren früh auf Modelle, Frameworks, Tools und Infrastruktur.
Dabei liegt ein grosser Teil des Aufwands häufig woanders: bei der Datenaufbereitung.
Zum Beispiel:
- Dubletten entfernen
- Kategorien vereinheitlichen
- fehlende Werte behandeln
- Strukturen harmonisieren
- Datenquellen zusammenführen
Diese Arbeit wirkt unspektakulär — entscheidet aber oft über den Erfolg eines Projekts.
Gute Daten schaffen bessere Entscheidungen
Datenqualität verbessert nicht nur KI-Systeme.
Sie verbessert auch:
- Reporting
- Prozesse
- Analysen
- Transparenz
- operative Entscheidungen
Oft entsteht bereits durch bessere Datenstruktur grosser Mehrwert — noch bevor ein Modell trainiert wird.
Modell verbessern oder Daten verbessern?
Viele Unternehmen reagieren auf schlechte Resultate mit komplexeren Modellen.
Das ist häufig der falsche Hebel.
Denn ein leistungsfähigeres Modell kompensiert selten grundlegende Datenprobleme.
Oft lohnt es sich mehr:
- Datenqualität zu erhöhen
- Strukturen zu vereinheitlichen
- Inkonsistenzen zu reduzieren
- Prozesse sauberer aufzubauen
Gezielte Verbesserungen der Datenbasis erzeugen häufig grössere Effekte als komplexere Algorithmen.
Datenprobleme sind oft Prozessprobleme
Viele Qualitätsprobleme entstehen nicht technisch — sondern organisatorisch.
Zum Beispiel:
- unterschiedliche Definitionen
- unklare Verantwortlichkeiten
- manuelle Eingaben
- fehlende Standards
- mehrere parallele Systeme
Dadurch entstehen Inkonsistenzen bereits im Alltag.
Gute Datenqualität beginnt deshalb oft bei klareren Prozessen, saubereren Verantwortlichkeiten und verständlicheren Systemen.
Frühe Analyse spart später Aufwand
Viele KI-Projekte investieren erst spät in Datenanalyse.
Dann werden Probleme sichtbar, wenn bereits Modelle entwickelt, Systeme integriert oder Prozesse aufgebaut wurden.
Das erhöht Aufwand und Kosten massiv.
Sinnvoller ist: früh Klarheit über das tatsächliche Datenpotenzial zu schaffen.
Zum Beispiel:
- Welche Daten existieren?
- Wie konsistent sind sie?
- Welche Lücken bestehen?
- Welche Daten sind operativ relevant?
- Welche Qualität ist tatsächlich vorhanden?
Nicht jede Datenquelle ist wertvoll
Mehr Daten bedeuten nicht automatisch mehr Erkenntnis.
Viele Informationen werden nie genutzt, enthalten kaum Signal, sind operativ irrelevant oder erzeugen zusätzlichen Aufwand.
Deshalb ist Priorisierung wichtig. Welche Daten helfen tatsächlich dabei:
- bessere Entscheidungen zu treffen
- Prozesse zu verbessern
- Muster zu erkennen
- operative Probleme zu lösen?
Gute KI beginnt oft mit besserer Datenstruktur
Viele Unternehmen möchten direkt mit KI starten.
Oft liegt der grössere Hebel jedoch zuerst bei:
- saubereren Datenflüssen
- konsistenter Struktur
- klareren Definitionen
- besserer Zugänglichkeit
- stabileren Prozessen
Dadurch entstehen bessere Voraussetzungen — nicht nur für KI, sondern für digitale Entscheidungen insgesamt.
Unser Ansatz
Wir starten nicht mit Modellen.
Wir starten mit Fragen wie:
- Welche Daten existieren bereits?
- Wie zuverlässig sind sie?
- Welche Prozesse erzeugen Inkonsistenzen?
- Welche Informationen fehlen?
- Welche Daten haben tatsächlich operativen Wert?
Erst danach entscheiden wir:
- ob KI sinnvoll ist
- welche Daten relevant sind
- und wie klein sinnvoll gestartet werden kann
Fazit
Grosse Datenmengen garantieren keine guten KI-Ergebnisse.
Entscheidend ist:
- Datenqualität
- Konsistenz
- Relevanz
- und operative Nutzbarkeit
Gerade für KMU entstehen oft die besten Resultate nicht durch maximale Datenmengen — sondern durch saubere, verständliche und gut strukturierte Informationen.
Denn gute KI beginnt selten mit mehr Daten. Sondern mit besseren Daten.