Warum klassische Textsuche an Grenzen stösst
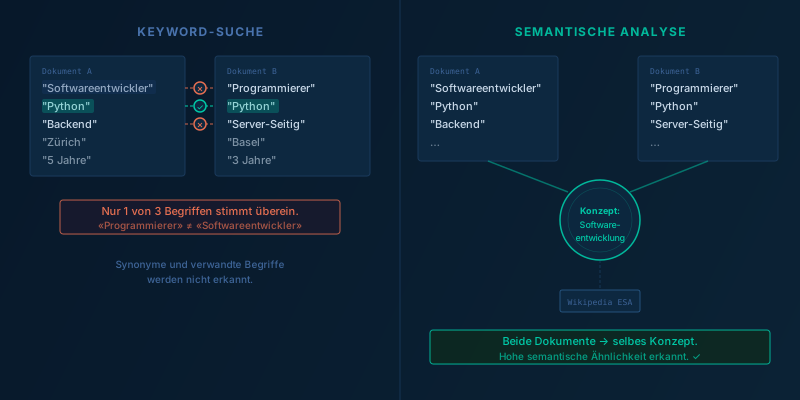
Traditionelle Suchsysteme arbeiten oft keywordbasiert. Das funktioniert gut, solange exakt dieselben Begriffe verwendet werden. In der Praxis entstehen jedoch schnell Probleme:
- unterschiedliche Schreibweisen
- Synonyme
- Fachbegriffe
- Kontextabhängigkeit
- Mehrdeutigkeiten
- unterschiedliche Ausdrucksweisen
Zwei Dokumente können inhaltlich fast identisch sein — ohne dieselben Wörter zu verwenden. Genau deshalb wird semantische Analyse relevant.
Vom Keyword zur Bedeutung
Semantische Systeme versuchen nicht nur Wörter zu erkennen, sondern Konzepte und Zusammenhänge. Die zentrale Frage lautet: «Worum geht es in diesem Dokument tatsächlich?»
Dadurch entstehen deutlich intelligentere Möglichkeiten für:
- Dokumentensuche
- Matching
- Empfehlungssysteme
- Wissensmanagement
- Skill-Mapping
- automatische Klassifikation
Wie Wikipedia zur Wissensbasis wird
Im Forschungsprojekt wurde genau dafür ein semantisches Modell entwickelt — auf Basis der deutschen Wikipedia. Warum Wikipedia?
- riesige Mengen strukturierter Inhalte
- Konzepte werden miteinander verknüpft
- thematische Beziehungen werden abgebildet
- kontinuierliche Erweiterung
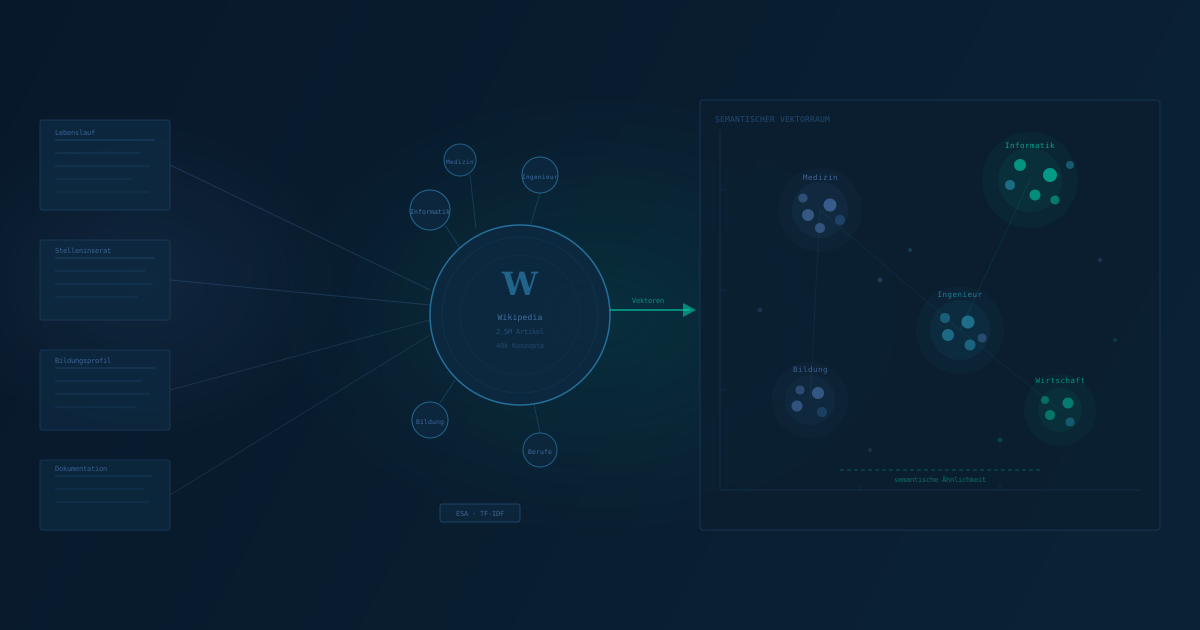
Jeder Wikipedia-Artikel wurde dabei als semantisches Konzept verstanden. Dadurch entstand ein grosser Wissensraum, in dem Dokumente semantisch positioniert werden können.
Der technische Ansatz: Explicit Semantic Analysis
Das Projekt basiert auf einem ESA-inspirierten Ansatz (Explicit Semantic Analysis). Die Idee: Texte werden nicht direkt miteinander verglichen, sondern über Konzepte, die aus einer Wissensbasis abgeleitet werden.
Dadurch entsteht eine semantische Beschreibung eines Dokuments — eine Art inhaltlicher Fingerabdruck.
Ein konkretes Anwendungsproblem: Matching
Der Forschungsfokus lag nicht nur auf allgemeiner Textanalyse, sondern auf einem konkreten Problem: automatisiertes Matching zwischen:
- Lebensläufen
- Ausbildungsprofilen
- Stelleninseraten
- Kompetenzen
- Fähigkeiten
- Bildungswegen
Das Ziel: nicht nur Keywords erkennen — sondern tatsächliche inhaltliche Nähe.
Semantisches Matching statt starre Kategorien
Klassische Systeme arbeiten oft mit festen Kategorien, Schlagwortlisten und statischen Filtern. Das Problem: Menschen beschreiben Fähigkeiten unterschiedlich.
Ein semantischer Ansatz kann trotzdem Zusammenhänge erkennen — zum Beispiel ähnliche Fachgebiete, verwandte Kompetenzen, inhaltliche Überschneidungen und ähnliche Berufsfelder. Dadurch entsteht deutlich flexibleres Matching.
Die Herausforderung: unstrukturierte Dokumente
Ein zentrales Problem war die Analyse unstrukturierter und semi-strukturierter Dokumente. Gerade Lebensläufe oder Stellenprofile unterscheiden sich stark:
- unterschiedliche Formate
- verschiedene Schreibstile
- uneinheitliche Struktur
- individuelle Begrifflichkeiten
Das macht klassische Analyse schwierig.
Wie das System aufgebaut wurde
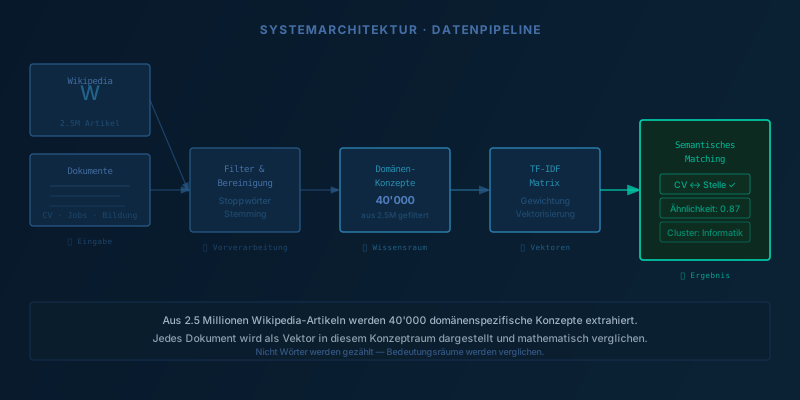
Die Architektur bestand aus mehreren Schritten:
- Wikipedia-Dump analysieren
- irrelevante Inhalte entfernen
- Konzepte erweitern und bereinigen
- domänenspezifisch filtern
- semantische Matrix erzeugen
- Dokumente als Vektoren darstellen
Dadurch entstand ein spezialisierter Wissensraum für Bildungs- und Jobprofile.
Domain-spezifische KI statt generisches Modell
Ein besonders interessanter Punkt: Das Modell wurde bewusst auf einen spezifischen Bereich fokussiert. Nicht die gesamte Wikipedia war relevant — sondern nur Inhalte, die mit Ausbildung, Kompetenzen, Berufen, Jobprofilen und Fähigkeiten zusammenhängen.
Dadurch reduzierte sich das Rauschen erheblich.
Warum Spezialisierung wichtig ist
Viele KI-Systeme scheitern an zu allgemeinem Kontext. Domain-spezifische Modelle sind oft deutlich präziser, weil:
- Fachbegriffe besser verstanden werden
- irrelevante Informationen verschwinden
- Beziehungen klarer werden
- semantische Nähe realistischer berechnet wird
Millionen von Wikipedia-Artikeln als Grundlage
Die Datenbasis war enorm:
- ca. 2.5 Millionen Wikipedia-Seiten
- über 3 Millionen validierte Einträge nach Erweiterung
- später reduziert auf rund 40'000 domänenspezifische Konzepte
Zusätzlich wurden Lebensläufe, Bildungsbeschreibungen und Jobinserate in das Modell integriert.
Texte werden mathematisch vergleichbar
Die Inhalte wurden anschliessend in Vektoren transformiert. Zum Einsatz kam TF-IDF (Term Frequency – Inverse Document Frequency). Dadurch konnten Dokumente mathematisch verglichen werden: Ähnlichkeit, Distanz, thematische Nähe und gemeinsame Konzepte wurden berechenbar.
Was das praktisch ermöglicht
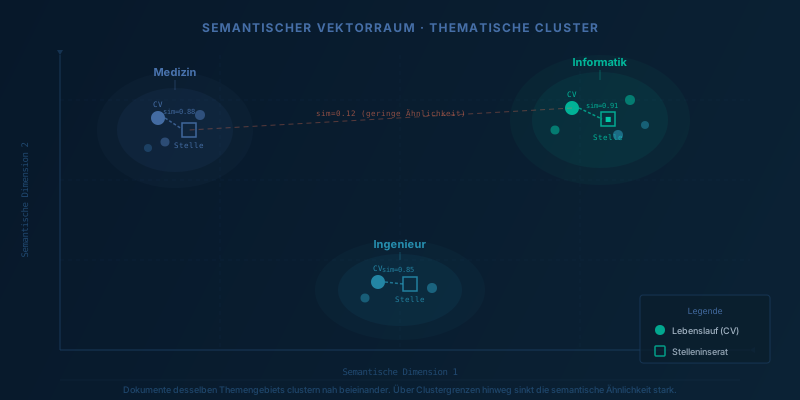
Dadurch konnten beispielsweise ähnliche Lebensläufe erkannt, passende Stellenprofile vorgeschlagen, Ausbildungswege verglichen und semantische Cluster gebildet werden.
Das System arbeitete also nicht nur mit Keywords — sondern mit Bedeutungsräumen.
Thematische Cluster als Erkenntnisquelle
In den Experimenten entstanden klar erkennbare Cluster. Zum Beispiel wurden technische Berufe, Gesundheitswesen, Informatik und Maschinenbau semantisch gruppiert.
Das zeigt: Das Modell erkannte tatsächlich thematische Zusammenhänge — weit über einfache Keyword-Übereinstimmungen hinaus.
Warum solche Systeme heute relevanter denn je sind
Die Grundidee des Projekts ist heute aktueller denn je. Unternehmen arbeiten zunehmend mit Wissensdatenbanken, Dokumentensammlungen, internen Plattformen, KI-Suche, RAG-Systemen, semantischer Suche, Embeddings und Wissensgraphen.
Die Herausforderung bleibt dieselbe: Wie macht man Wissen maschinell verständlich?
Semantische Suche verändert Wissensarbeit
Moderne KI-Systeme entwickeln sich weg von klassischer Suche — hin zu semantischem Verständnis. Heute sichtbar bei ChatGPT, Enterprise Search, RAG-Systemen, Copilots und Wissensassistenten.
Die Grundprinzipien bleiben ähnlich: Konzepte erkennen, Kontext verstehen, semantische Nähe berechnen, Inhalte intelligent verknüpfen.
Gute KI braucht gute Wissensstrukturen
Ein zentraler Punkt des Projekts: Nicht das Modell allein entscheidet. Sondern Datenqualität, Struktur, Kontext, semantische Relevanz und Domänenverständnis.
Genau deshalb funktionieren generische Systeme oft schlechter als gut strukturierte, fokussierte Modelle.
Infrastruktur bleibt entscheidend
Viele KI-Diskussionen fokussieren heute auf Modelle. Das Projekt zeigt jedoch: Der grössere Aufwand liegt oft bei Datenaufbereitung, Strukturierung, Wissensmodellierung, semantischer Filterung und Architektur.
Erst dadurch entstehen wirklich nutzbare Systeme.
Zur Forschungsarbeit
Dieser Beitrag basiert auf einer wissenschaftlichen Arbeit, die den vollständigen methodischen Aufbau beschreibt: von der Wikipedia-Datenbasis über ESA und TF-IDF bis zur domänenspezifischen Filterung und dem semantischen Matching von Karriere- und Bildungsdokumenten.
Originalpaper: A Domain Specific ESA Inspired Approach for Document Semantic Description (Zenodo)Fazit
Semantische Dokumentenanalyse verändert, wie Informationen verstanden und verknüpft werden können. Das vorgestellte Forschungsprojekt zeigt, wie aus Wikipedia, Lebensläufen, Stellenprofilen und Bildungsdaten ein intelligentes semantisches Wissensmodell entsteht.
Nicht Keywords stehen im Zentrum — sondern Bedeutung. Und genau darin liegt bis heute einer der wichtigsten Hebel moderner KI-Systeme: Informationen nicht nur speichern — sondern tatsächlich verstehen.